Studie KI-Performance Arzneimittel 2026
Wie sichtbar sind wir in KI-Systemen wie ChatGPT, Claude und Perplexity? Wo stehen unsere unmittelbaren Wettbewerber? Welche Quellen prägen die Antworten besonders stark? Wo liegen die größten Potenziale zur Verbesserung von Präsenz und Tonalität?
Die Studie zeigt, wie sichtbar Marken aus dem Segment Arzneimittel in KI‑gestützten Such- und Assistenzsystemen sind. Auf Basis von jeweils 50 realitätsnahen Nutzeranfragen an zehn Large Language Models analysiert sie die Präsenz von insgesamt 779 Marken. Enthalten sind Rankings und Detailauswertungen über alle LLMs hinweg sowie differenzierte Analysen nach LLM, Produktkategorien, Anbietergruppen, Quellen und Tonalität.
148 Seiten, 2.000 Euro zzgl. MwSt.
Teil der Studienreihe KI-Performance.
zum → Studiensteckbrief mit Beispielcharts, Bestellformular, Infografik, Inhaltsverzeichnis, Methodik
Nutzwert der Studie:
- welche der 779 Marken erzielen eine hohe KI-Performance, welche bekannten Arzneimittelmarken finden sich jenseits der Top 100?
- in welchen Produktkategorien bzw. medizinischen Fachgebieten sind welche Marken bei KI-Systemen besonders präsent und wo zeigen sich klare Spezialisierungsmuster?
- welche Anbietergruppen performen in den KI-Antworten überproportional stark im Verhältnis zu ihrer Gruppengröße und welche Firmen bündeln über ihr Markenportfolio die meiste KI-Performance?
- welche Large Language Models bevorzugen welche Marken und Quellen – welche Unterschiede erfordern eine differenzierte Content-Strategie?
- wer sind die Benchmark-Quellen, die von KI-Systemen am häufigsten zitiert werden und welche Marken profitieren von Gesundheitsportalen, Fachinstitutionen und Apotheken?
- wie unterscheidet sich die Tonalität der KI-Antworten zwischen den Marken und welche Positionierungsmuster ergeben sich aus den positiven Begriffen?
Studiendesign:
- Methode: Systematische Befragung von 10 Large Language Models mit jeweils 50 realitätsnah formulierten Nutzeranfragen je Modell; Erfassung aller genannten Marken je Antwort und Gewichtung nach Rangposition; Auswertung der Responses nach Markennennungen, Produktkategorie, Quellenverweisen, Platzierungen und Tonalität im Satzkontext; Aggregation zu einem Gesamtranking der Marken und Firmen.
- Untersuchungsraum/Sprache: deutschsprachiger Raum (deutschsprachige Nutzeranfragen).
- Scope: 14 Produktkategorien/medizinische Fachgebiete rund um rezeptfreie Arzneimittel.
- Berechnungen/Analysen: Rankings der Marken und Firmen, Konzentrationsanalyse (Lorenzkurven), Quellenanalyse mit Zitationshäufigkeiten, Tonalitäts-/Sentimentanalyse, Positionierungsanalyse (Korrespondenzanalyse und Konzentrationsmatrix).
Studie in Zahlen:
- 779 sichtbare Marken von 504 Firmen im Arzneimittelmarkt
- 10 LLMs: ChatGPT, Claude, Copilot, DeepSeek, Gemini, Grok, LLaMA, Mistral, Perplexity, Qwen
- 50 Anfragen je LLM
- 14 Produktkategorien
- 10 Anbietergruppen
- 5.500 maximal erreichbare KI-Performance Punkte
Untersuchte Marken:
1A Pharma, ALIUD PHARMA, Allegra, Antistax, Artelac, Aspirin, Bayer, ben-u-ron, Bepanthen, Canesten, Chlorhexamed, Dentinox, Dolormin, Dynexan Mundgel, Elotrans, Faktu, Fenistil, Granu Fink, Hametum, Heumann, HEXAL, Iberogast, KadeFungin, Kamistad, Kytta, Lamisil, Lasea, Lefax, Lorano, Nasivin, Neurexan, Nizoral, Nurofen, Oralpädon, Otalgan, Otriven, Pascoflair, Pencivir, Perenterol, Posterisan, Propecia, Prostagutt, ratiopharm, Regaine, Remifemin, Soventol, STADA, Thomapyrin, Voltaren, Zovirax und weitere 729 Marken
Analysierte Produktkategorien:
Dermatologie, Diabetologie, Gastroenterologie, Gynäkologie, HNO, Kardiologie, Neurologie, Ophthalmologie, Orthopädie, Pädiatrie, Psychiatrie, Urologie, Zahnmedizin, Fachgebietsübergreifend
Analysierte Anbietertypen:
Apotheken, Arzneimittelhersteller, Institutionen & Fachquellen, Kosmetik & Körperpflege, Medien & Influencer, MedProd. & MedTech., Nahrungsergänzungsmittel, Sonstige Anbieter, Universalhändler & Handel, Vergleichsportale
Ausgewählte Ergebnisse:
Insgesamt wurden 779 Marken von 504 Firmen in den Antworten der zehn untersuchten LLMs erfasst. Anders als in stärker konsolidierten Branchen ist die KI-Präsenz breit gestreut: Auf die Top‑10‑Marken entfallen nur rund 15 % der gesamten KI‑Performance‑Punkte, auf die Top‑10‑Firmen dagegen 33,5 % – große Hersteller bündeln ihre Sichtbarkeit über breite Markenportfolios. Angeführt wird das Ranking von ratiopharm, das in sechs von zehn Sprachmodellen die Nummer 1 belegt, vor Bepanthen und den Versandapotheken SHOP APOTHEKE und DocMorris. Arzneimittelhersteller erzielen rund 59 % der Punkte, doch Apotheken, Gesundheitsmedien und Fachquellen prägen die Antworten deutlich mit. In den Produktkategorien setzen sich häufig Spezialisten durch: Acht der 14 Kategoriesieger, darunter Posterisan, Canesten, Otriven und Chlorhexamed, stehen außerhalb der Gesamt‑Top‑10. Die meistzitierten Quellen sind nhs.uk, apotheken-umschau.de, nih.gov und shop-apotheke.com – Gesundheitsinstitutionen und Apothekenportale liefern damit das inhaltliche Fundament der KI-Antworten. Zwischen den zehn LLMs zeigen sich substanzielle Unterschiede in der Markenauswahl (Copilot nennt 71 Marken, Claude 314; bei ChatGPT führt mit dem NHS eine Institution, bei LLaMA die Apotheken Umschau) sowie in Tonalität, Begründungsmustern und Positionierungslogik: Grok formuliert am positivsten, Copilot am zurückhaltendsten. Für Marken bedeutet das: Eine pauschale „KI-Strategie“ reicht nicht aus. Gefragt ist eine differenzierte KI-Content- und PR-Strategie, welche die Eigenheiten der einzelnen Modelle gezielt adressiert.
Diese Studie hilft, wenn ...
… Sie wissen möchten, wie präsent Ihre Marke im KI-Kosmos ist
… Sie befürchten, Newcomer mit Potenzial zu spät zu entdecken
… Sie Sorge haben, relevante Wettbewerber nicht auf der Rechnung zu haben
… Sie erkennen wollen, in welchen Kontexten Ihre Marke negativ erwähnt wird
… Sie wissen möchten, ob Ihre KI-Performance mit der Ihrer wichtigsten Konkurrenten mithalten kann
… Sie einen aktuellen Überblick über die relevanten Quellen der LLMs zu Ihrer Branche benötigen
… Sie wissen möchten, bei welchen Produktkategorien Ihre Marke Potenzial besitzt
Dies sind einige gute Gründe, sich diese Marketingstudie anzuschaffen. Mit insgesamt 500 Prompts wurden die gebräuchlichsten Verbraucheranfragen an KI-Systeme simuliert und deren Antworten analysiert.
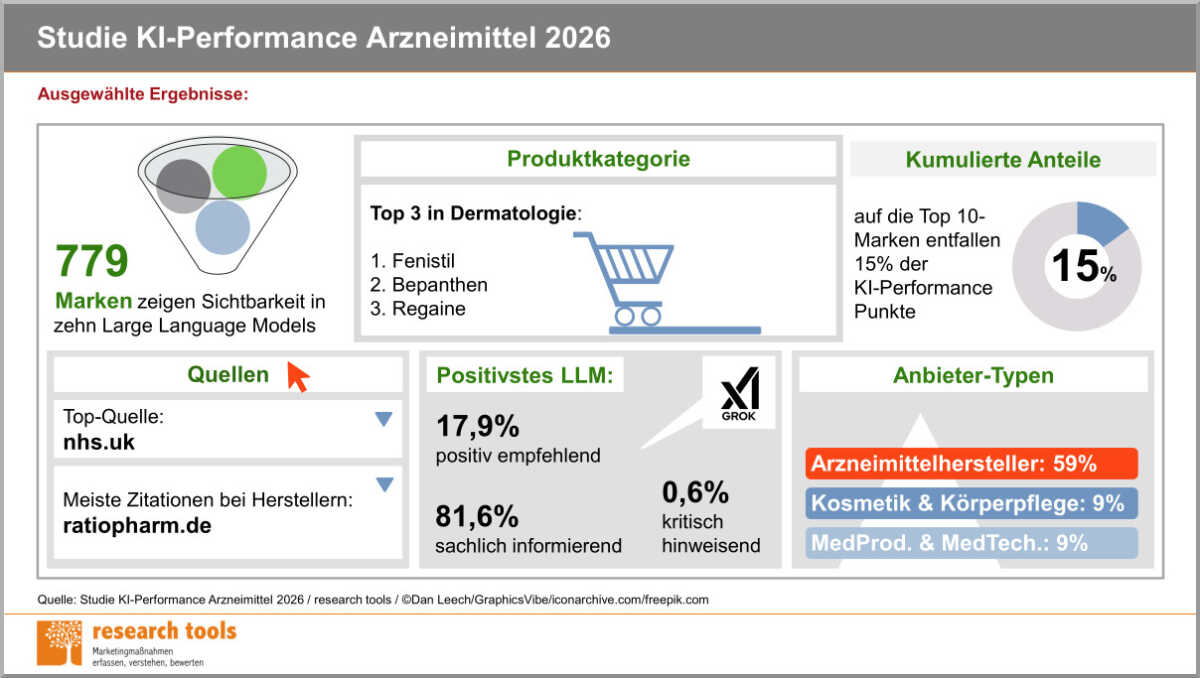
→ zum Vergrößern Infografik bitte anklicken


Weitere Studien zur Branche Healthcare
 Für ein Angebot klicken Sie
 Zur Bestellung der Studie klicken Sie
Häufige Fragen zur Studie
Kritische Rückfragen aus Gesprächen mit Arzneimittelherstellern, Apotheken und Agenturen – hier offen beantwortet.
Apotheken, Medien und Fachquellen konkurrieren zwar um Sichtbarkeit, sind aber keine direkten Wettbewerber von Arzneimittelherstellern. Ist das eine Verzerrung?
- Erfasst wird, was die Modelle auf eine Verbraucherfrage ausgeben. Nennt ein Modell eine Versandapotheke, ein Gesundheitsportal oder eine Fachinstitution, besetzt diese real den Platz, den sonst eine Arzneimittelmarke hätte. Aus Nutzersicht ist das der Wettbewerb um Aufmerksamkeit.
- Die Systematik aus 10 Anbietergruppen erlaubt jederzeit den Vergleich innerhalb der eigenen Gruppe: Arzneimittelhersteller stellen 58,5 % der Punkte, die übrigen neun Gruppen – von Apotheken über Medien und Fachinstitutionen bis zu Anbietern von Kosmetik und Medizinprodukten – zusammen 41,5 %. Für jede Anbietergruppe weist die Studie ein eigenes Ranking aus.
- Der eigentliche Erkenntniswert liegt in der Mischung: Dass Versandapotheken wie DocMorris, Gesundheitsmedien und internationale Gesundheitsinstitutionen wie der britische NHS im Ranking weit vorn liegen und zugleich zu den meistzitierten Quellen gehören, ist das strategische Signal: Wer in der KI-Antwort vorkommen will, muss in deren Quellen vorkommen.
Werden Spezialisten mit schmalem Sortiment benachteiligt, weil sie nicht in allen Fachgebieten punkten können?
Welchen konkreten Nutzen hat ein Unternehmen, das nicht unter den Top-Anbietern liegt?
- Nennposition statt Punktzahl. Der Ø-Rang zeigt, wie weit vorn eine Marke steht, wenn sie genannt wird. Marken außerhalb der Top 10 erreichen hier teils bessere Werte als etablierte Top-10-Marken – Otriven etwa liegt knapp außerhalb der Top 10, mit seinem Ø-Rang aber vor vier von ihnen. Das ist kein Überzeugungs-, sondern ein Anlassproblem.
- Modell-Blindspots. Für jede Marke ist ausgewiesen, in welchen Modellen sie stark, schwach oder gar nicht vertreten ist. Selbst drei Marken aus der Top 10 fehlen in mindestens einem Modell vollständig – HEXAL etwa bei Mistral –, während sie in anderen zu den stärksten zählen – jeweils eine konkrete, priorisierbare Lücke.
- Quellenprofil. Je Marke wird aufgeschlüsselt, welcher Anbietertyp die Sichtbarkeit trägt. Die Spannweite ist groß: Bei manchen Marken stammen drei Viertel der Quellenverweise von der eigenen Website, bei anderen tragen Apotheken oder Medien rund ein Drittel der Sichtbarkeit. Daraus folgt unmittelbar, an welchem Hebel zu arbeiten ist.
- Kategorie-Benchmark. Vergleich innerhalb des eigenen Fachgebiets und der eigenen Anbietergruppe statt gegen den Gesamtmarkt.
Welchen Mehrwert bietet die Studie gegenüber einer eigenen Recherche mit den LLMs – außer Zeitersparnis?
- Wettbewerbsvergleich. Die eigene Abfrage zeigt nur die eigene Marke. Die Studie liefert die Position relativ zu allen übrigen der 779 erfassten Marken – ohne Vergleichsbasis ist ein Einzelbefund nicht interpretierbar.
- Systematik statt Stichprobe. 50 methodisch konstruierte Anfragen über typische Suchintentionen und 14 Produktkategorien statt Ad-hoc-Fragen, deren Formulierung das Ergebnis bereits mitbestimmt.
- Neutralität. Eigene Abfragen laufen typischerweise in personalisierten Accounts mit Verlauf und mit Markenbias in der Fragestellung. Die Studie arbeitet mit neutralen Zugängen und markenfreien Anfragen.
- Zehn Modelle parallel. Inklusive der Modelle, die man selbst nicht nutzt, die Kunden aber nutzen – und inklusive der Erkenntnis, welche Modelle die eigene Marke ignorieren.
- Quellenanalyse. Die eigentliche Handlungsebene: 5.752 Zitationen über 873 Basisquellen, manuell nicht darstellbar.
- Auswertungstiefe. Sentiment- und Positionierungsanalyse, Korrespondenzanalyse, Anbietergruppen- und Kategoriematrizen auf Basis eines Korpus von rund 72.000 Wörtern.
- Objektivität und Zitierfähigkeit. Unabhängig erstellt, methodisch dokumentiert, extern belastbar – verwendbar gegenüber Vorstand, Vertrieb und Presse.
Warum zählen alle Modelle gleich, obwohl ChatGPT dominiert?
Sind 50 Anfragen nicht sehr wenig?
- Kategoriensystem vorab festgelegt. Die zwölf Themenfelder (z. B. Allergie & Heuschnupfen, Erkältung, Magen & Darm, Schmerzen) wurden nicht von der KI bestimmt, sondern aus einer Vorrecherche bei führenden Anbietern und aus früheren Studien abgeleitet. Die KI durfte maximal zwei weitere Kategorien vorschlagen und begründen. Für die Auswertung wurden die Anfragen anschließend 14 medizinischen Fachgebieten zugeordnet. Die Struktur ist gesetzt, nicht generiert.
- Generierung mit steuerndem Prompt. Vorgegeben waren realistische Nutzungsanlässe, ein Mix aus mindestens 20 Stichwortanfragen und 40 ausformulierten Fragen sowie ein kleinerer Anteil kritischer Töne wie ausbleibende Wirkung, Lieferengpässe oder Preissteigerungen.
- Fachliche Kontrolle und Überarbeitung. Der KI-Output war der Entwurf, nicht das Ergebnis: Jede Anfrage wurde auf Basis der Marktforschungs- und Branchenexpertise geprüft, überarbeitet oder verworfen – von 60 generierten auf 50 eingesetzte Anfragen.
- Externe Validierung (Reverse Engineering). Die Formulierungen wurden gegen nutzergenerierte Inhalte auf Gesundheits- und Verbraucherportalen, in Foren und auf Bewertungsplattformen gespiegelt: Sprechen echte Verbraucher so? Kommen diese Anliegen dort tatsächlich vor? Erst danach ging eine Anfrage ins Feld.
